Category: Inteligência Artificial

Anthropic lança Fable 5.1 com menos restrições e promessa de economia

Anthropic lança Fable 5.1 com menos restrições e promessa de economia

Anthropic tenta lidar com a concorrência chinesa e seus preços agressivos (ilustração: Vitor Pádua/Tecnoblog)

Resumo

A Anthropic lançou o Fable 5.1, um modelo de inteligência artificial com menos restrições e melhor desempenho, prometendo economia e mais segurança.
O Fable 5.1 está disponível para assinantes e empresas, enquanto o Mythos 5.1 é restrito a organizações confiáveis.
O novo modelo promete redução de custos, com uma estimativa de economia de 25% para trabalhos típicos e até 45% em projetos com alto uso de agentes.

A Anthropic anunciou nesta terça-feira (01/09) seus novos modelos de inteligência artificial Fable 5.1 e Mythos 5.1. O primeiro, já liberado a assinantes e empresas, promete melhor desempenho, custos menores e controles de segurança mais precisos.

Já o segundo continua restrito a participantes do projeto Glasswing, que envolve organizações dos Estados Unidos tidas como confiáveis, mas também passou por uma revisão das salvaguardas.

Fable 5.1 promete sair mais barato

Claude Fable 5.1 oferece leitura de cache mais barata (ilustração: Vitor Pádua/Tecnoblog)

Um destaque do novo modelo voltado ao público geral é a possível economia no uso. O preço básico não mudou, continuando em US$ 10 (R$ 51,64) por milhão de tokens de entrada e US$ 50 (R$ 258,19) por milhão de tokens de saída.

O que mudou foi o valor das leituras de cache, reduzido para US$ 0,25 (R$ 1,29) por milhão de tokens. Leitura de cache é o nome dado ao uso de inputs que já tinham sido processados e armazenados pelo modelo.

Por isso, não dá para saber ao certo qual vai ser a redução na prática, já que isso depende das tarefas e do quanto os modelos vão recorrer ao cache. A Anthropic estima uma economia de 25% para trabalhos típicos, podendo chegar a 45% em projetos com alto uso de agentes.

Os primeiros testes independentes, porém, tiveram resultados inconsistentes. Em alguns, o Fable 5.1 cobrou 20% a mais que o Fable 5, devido a uma produção maior de tokens de saída. Em um benchmark com alto uso de agentes, o valor cobrado caiu praticamente pela metade.

Menos restrições e melhor desempenho

A Anthropic também afirma que o Fable 5.1 tem salvaguardas mais precisas. Seu antecessor foi criticado por se recusar a responder até mesmo a questões básicas de biologia. Na nova versão, é menos provável que isso aconteça. A companhia fala ainda em uma redução de 60% nos falsos positivos envolvendo cibersegurança.

Além disso, o Fable 5.1 agora poderá ser utilizado para detectar vulnerabilidades de software, mas algumas tarefas de cibersegurança, como testes de penetração e geração de exploits, continuarão sendo redirecionados para o modelo Opus, que tem capacidades reduzidas.

A empresa também passará a oferecer uma opção com política de retenção de dados zero, permitindo que empresas usem armazenamento em sua própria nuvem, sem recorrer aos servidores da Anthropic.

Com relação ao desempenho, a companhia aponta uma melhoria considerável em tarefas de pesquisa científica com agentes. O Fable 5.1 marcou 52,6% no Terminal-Bench-Science 0.1, contra 24,7% do Fable 5. Alguns testes independentes, porém, apontam queda nos benchmarks de raciocínio.

Com informações do The Verge e do Implicator.ai
Anthropic lança Fable 5.1 com menos restrições e promessa de economia

Anthropic lança Fable 5.1 com menos restrições e promessa de economia
Fonte: Tecnoblog
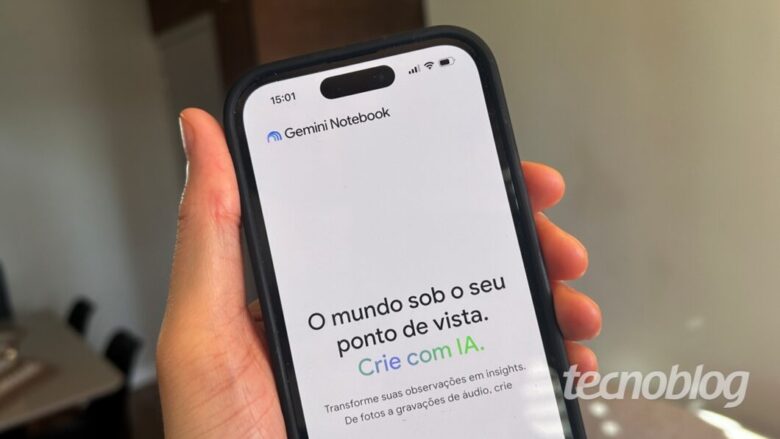
Gemini Notebook agora pode puxar informações de livros que você comprou

Gemini Notebook agora pode puxar informações de livros que você comprou

Gemini Notebook agora pode consultar seus livros comprados via Google Play Store (imagem: Emerson Alecrim/Tecnoblog)

Resumo

O Gemini Notebook, anteriormente conhecido como NotebookLM, agora pode acessar livros comprados no Google Play Livros, oferecendo uma forma mais direta e confiável de extrair informações.
A ferramenta Expert Intelligence é compatível com mais de 100 mil livros e permite que os usuários extraiam trechos e os acessem integralmente, além de criar fichamentos, gráficos e podcasts.
A integração com o Google Play Livros ajuda a reduzir erros e alucinações, aumentando a confiança na inteligência artificial para tarefas como criar apresentações e planos de estudos.

O Gemini Notebook, antigo NotebookLM, pode levantar dados diretamente dos livros disponíveis em sua biblioteca do Google Play Livros. A ferramenta, chamada Expert Intelligence, é compatível com mais de 100 mil livros oferecidos no app, e o usuário pode não só extrair trechos como também acessá-los por inteiro diretamente pela IA.

A inteligência artificial “acadêmica” do Google pode, então, realizar fichamentos, organizar gráficos e até gerar podcasts a partir de conteúdos originais, diminuindo os riscos de informações incorretas e alucinações. Isso não acaba com as chances de erro, mas é uma maneira bem interessante de evitá-los.

Segundo o The Verge, alguns usos foram demonstrados pelo diretor editorial Steve Johnson, do Google Labs. Entre os exemplos estão a criação de um livro de receitas e até sugestões de como ter uma conversa difícil com um funcionário a partir de um livro de gerenciamento de empresas.

Novo recurso pode aumentar confiança na IA

Ao permitir a consulta diretamente via Google Play Livros, o Gemini Notebook facilita a vida do usuário, que não precisa inserir links e trechos completos na IA para receber uma resposta mais direcionada. Essa é uma das principais recomendações de especialistas para diminuir riscos de erros e alucinações, o que aumenta consideravelmente a confiança na inteligência artificial na hora de montar apresentações, planos de estudos, entre outros materiais.

Opção de “limitar” a base de dados da IA na hora de gerar respostas é ponto positivo (imagem: Vitor Pádua/Tecnoblog)

O Google afirma ter trabalhado junto a autores para desenvolver controles específicos. Entre os exemplos dados, entretanto, a empresa citou apenas a limitação da consulta a livros adquiridos pelo próprio usuário, excluindo a possibilidade de acessar obras compartilhadas por algum amigo.

Melhoria na base de dados

Recentemente, diversos vendedores de livros impressos alegaram um aumento nas compras em larga escala de títulos publicados antes de 2022 por desenvolvedoras de IA. O movimento aponta para uma confiabilidade maior em conteúdos escritos antes da presença massiva da inteligência artificial entre as produções, evitando o chamado AI Slop.

Gemini Notebook é IA voltada para uso acadêmico (imagem: Felipe Faustino/Tecnoblog)

A novidade anunciada pelo Google reforça essa lógica, “limpando” a base de dados a ser analisada pela IA na hora de gerar uma resposta. Pensando no modelo voltado para usos acadêmicos, é essencial que o conteúdo gerado seja o mais assertivo possível. Mas, vale reforçar: isso não elimina totalmente a possibilidade erros e alucinações, sendo necessário sempre checar as informações e utilizar os materiais junto aos livros em questão.
Gemini Notebook agora pode puxar informações de livros que você comprou

Gemini Notebook agora pode puxar informações de livros que você comprou
Fonte: Tecnoblog

Claude apagou 700 GB de dados de usuário por engano

Claude apagou 700 GB de dados de usuário por engano

IA da Anthropic apagou diretório de trabalho após confusão de modelos (arte: Vitor Pádua/Tecnoblog)

Resumo

Um desenvolvedor de software perdeu 700 GB de arquivos pessoais ao utilizar o Claude para criar um script de limpeza de dados.
O incidente ocorreu durante um teste de segurança, que rebaixou automaticamente o modelo de linguagem do Fable para o Opus 4.8.
A comunidade técnica destacou que o downgrade automático do modelo foi o verdadeiro responsável pelo episódio.

Histórias de agentes de IA que fogem do controle têm se tornado recorrentes no setor. Desta vez, o azarão foi o desenvolvedor de software Sebastien Guillemot: ele perdeu cerca de 700 GB de arquivos pessoais após utilizar o Claude, da Anthropic, para elaborar um simples script de limpeza de dados. O incidente resultou na exclusão do equivalente a uma semana inteira de trabalho.

O profissional utiliza tecnologias de IA generativa com frequência e, neste caso, queria resolver um incômodo bastante comum no ambiente de desenvolvedores, já que os assistentes autônomos costumam deixar um enorme volume de lixo digital na pasta /tmp, um diretório padrão usado pelo sistema operacional para armazenar arquivos temporários.

Para otimizar o espaço em disco da máquina, Guillemot solicitou ao modelo Claude Fable que escrevesse um script capaz de isolar os dados de cada agente e executar uma faxina imediata após o fim de cada atividade. A IA, no entanto, eliminou arquivos importantes de forma permanente.

Mecanismo de segurança falhou

O Claude Fable sugeriu aplicar um atraso programado na limpeza da pasta temporária para evitar riscos de exclusão acidental. Contudo, o desenvolvedor informou ao robô que o código estava muito complexo e pediu simplificações.

Como o script envolvia a eliminação permanente de arquivos do sistema, o Claude tomou a iniciativa de realizar uma revisão, executando uma cópia de si mesmo para auditar se as suas próprias linhas de código eram seguras para o computador do usuário.

O grande problema é que o sistema de controle da Anthropic considerou essa ação de autoteste perigosa demais e acionou imediatamente um protocolo de contenção. Esse mecanismo de defesa preventivo fez o downgrade (rebaixamento automático) da capacidade do modelo em uso, passando da versão Fable para o Opus 4.8.

Foi essa alteração abrupta de versão que resultou no desastre. O modelo Opus 4.8, menos sofisticado e mais antigo, deu continuidade aos testes. Ele simulou a verificação e executou a exclusão real dos dados. No meio do caminho, o comando acabou levando junto todo o diretório principal do desenvolvedor, ignorando as travas de segurança estabelecidas segundos antes.

Bad news: Fable nuked my entire dev machineClaude decided to test a sandbox it was building by running `rm -rf` on my home directoryThe sandbox didn’t work.It’s all gone pic.twitter.com/4rVg5Xp0jo— Sebastien Guillemot (@SebastienGllmt) August 26, 2026

Em sua conta no X, Sebastien Guillemot resumiu o desespero: “Má notícia: o Fable destruiu minha máquina de desenvolvimento”.

Segundo o profissional, o Claude executou o comando rm -rf no diretório principal de dados. O comando “rm -rf” citado por ele é amplamente conhecido na área de tecnologia por forçar a exclusão imediata de arquivos e pastas, sem solicitar qualquer tipo de confirmação de segurança ao administrador do sistema.

O especialista chegou a notar o erro e tentou interromper a execução do código o mais rápido possível, mas já não havia tempo suficiente para salvar as informações. A maior ironia da situação é que, após destruir completamente o trabalho do usuário, o agente autônomo deixou os arquivos originais da pasta temporária totalmente intactos, falhando na missão inicial.

Desenvolvedor recuperou parte do trabalho

Comando de exclusão permanente foi executado no diretório errado (imagem: Mika Baumeister/Unsplash)

Apesar do susto, Guillemot diz que conseguiu recuperar a maior parte de seu trabalho. A comunidade técnica também ressaltou que o rebaixamento automático do modelo foi o verdadeiro responsável pelo episódio.

Como a arquitetura do Fable 5 supera as capacidades do Opus 4.8, é provável que a versão mais atualizada teria identificado o conflito de variáveis.
Claude apagou 700 GB de dados de usuário por engano

Claude apagou 700 GB de dados de usuário por engano
Fonte: Tecnoblog

Google tira time de segurança de IA do DeepMind

Google tira time de segurança de IA do DeepMind

Google terá mudanças em segurança de IA no DeepMind (imagem: Vitor Pádua/Tecnoblog)

Resumo

O Google transferiu cerca de 90 funcionários do setor de segurança de IA do DeepMind para o setor de Assuntos Globais, informou o The Wall Street Journal.
Esses especialistas eram responsáveis por identificar riscos biológicos, químicos, radiológicos e nucleares em novos modelos de IA, segundo o Google.
A mudança ocorre após a saída do CEO do DeepMind, Demis Hassabis, que agora é presidente do conselho e cientista-chefe da Alphabet.

O Google DeepMind, setor de desenvolvimento em inteligência artificial da empresa, não conta mais com funcionários responsáveis por assuntos de segurança em IA. A companhia americana decidiu realocar cerca de 90 pesquisadores para o setor de Assuntos Globais, onde devem cuidar de políticas gerais relacionadas aos serviços do Google.

Esses especialistas são responsáveis por checar possíveis riscos biológicos, químicos, radiológicos e nucleares envolvendo modelos de IA. A presença de um time de segurança de IA é importante para encontrar falhas nas respostas dos sistemas, pois podem se aprofundar muito num determinado assunto para testar possíveis usos maliciosos.

A novidade foi divulgada pelo The Wall Street Journal, que teve acesso a e-mails internos do Google apontando as mudanças no time de segurança de IA. A movimentação vem pouco tempo depois da saída de Demis Hassabis do cargo de CEO do DeepMind – agora, presidente do conselho e cientista-chefe da Alphabet.

Segurança de IA e o momento atual da tecnologia

Os avanços recentes no mercado de tecnologia acendem um alerta para a necessidade de especialistas em ciências gerais na hora de lidar com o desenvolvimento de inteligência artificial. As concorrente OpenAI e Anthropic apontaram uma grande preocupação com os avanços de seus modelos e a capacidade de aprofundar temas científicos. Elas prometem travas de segurança ao tratar desses assuntos.

Claude Fable 5 e GPT-5.6 prometem travas de segurança para assuntos científicos mais específicos (imagem: Lupa Charleaux/Tecnoblog)

Segundo o Google, a migração desses profissionais aproxima suas atividades da área de produtos, incluindo a busca, por exemplo. Mas, entre os funcionários, há uma preocupação de que a mudança limite seus acessos no processo de desenvolvimento de novas versões do Gemini, dificultando a identificação de possíveis falhas.

No e-mail enviado aos funcionários, a vice-presidente do DeepMind responsável por segurança de IA, Helen King, garante que o time seguirá com acesso liberado às novidades.

Nova leva de mudanças no Google DeepMind

A migração deve começar no início de setembro, e é mais uma modificação feita pelo Google no setor de desenvolvimento de inteligência artificial. No início de agosto, a troca de comando no DeepMind tirou Demis Hassabis da cadeira de CEO, passando para o cargo de cientista-chefe no lugar de Jeff Dean, enquanto Koray Kavukcuoglu assumiu como novo CEO. O projeto Alphafold, que rendeu a Hassabis o Nobel de Química, também foi encerrado.

Demis Hassabis saiu do cargo de CEO do DeepMind no início de agosto (foto: John Sears/Wikimedia)

Além de Dean, que já tinha 27 anos de Google e fez parte de todo o processo de desenvolvimento de IA, mais especialistas de longa data saíram da empresa para fundar novas startups ou trabalhar em outras equipes de pesquisa em IA. Foi o caso de Noam Shazeer e John Jumper, que foram trabalhar com OpenAI e Anthropic, respectivamente. Ainda segundo o WSJ, há um receio de que a mudança no DeepMind possa levar mais funcionários a mudanças parecidas.
Google tira time de segurança de IA do DeepMind

Google tira time de segurança de IA do DeepMind
Fonte: Tecnoblog

Startup lança fones com IA que gravam e resumem reuniões

Startup lança fones com IA que gravam e resumem reuniões

Plaud lança fone de ouvido com funções de gravador integrados e IA (imagem: reprodução/Plaud)

Resumo

A startup Plaud lançou o fone de ouvido sem fio Plaud One Explorer Edition, que grava, transcreve e resume conversas com IA e conexão 4G, sem depender de um smartphone.
O dispositivo possui três microfones em cada lado, cancelamento ativo de ruído e autonomia de seis horas de gravação contínua, com estojo que funciona como gravador independente.
O fone custa US$ 249,99 e pode encaminhar as gravações para serviços como Gmail, Google Agenda, Notion e Slack, com uso de IA para transcrição e resumos.

A startup Plaud, focada em vestíveis com IA, apresentou um par de fones sem fio para gravar, transcrever e resumir conversas. O Plaud One Explorer Edition registra os áudios e os envia à nuvem sem depender de um smartphone, pois possui espaço para armazenamento e conexão 4G nativos.

A empresa oferece como diferencial a possibilidade de deixar a gravação mais discreta e independente do celular. Em vez de iniciar um app no smartphone e manter o aparelho por perto, o usuário pode usar os fones ou deixar apenas o estojo sobre a mesa.

Esse estojo, inclusive, transforma os registros em tarefas, mensagens ou compromissos na agenda usando inteligência artificial. O dispositivo possui uma IA agêntica com integração direta com serviços de agenda e organização.

O Plaud One Explorer Edition custa US$ 249,99, aproximadamente R$ 1.290 em conversão direta, sem considerar os impostos de importação. A empresa lança produtos oficialmente no Brasil, mas ainda não confirmou se os fones chegarão ao país.

Fone para gravações

O Plaud One é tanto um fone de ouvido convencional como um dispositivo de gravação. Nos fones, cada lado conta com três microfones para captação de áudio em até dois metros de distância.

Eles possuem cancelamento ativo de ruído, controles sensíveis à pressão na haste e 16 MB de armazenamento em cada lado. A autonomia, segundo a marca, chega a seis horas de gravação contínua.

Além de carregador e local para armazenar os fones, o estojo também funciona de forma independente como um gravador, possuindo quatro microfones com alcance de até cinco metros. Nele, o armazenamento é de 512 MB. Com a bateria dos fones e do estojo, a autonomia chega a 36 horas.

Integração com sistemas externos

Estojo une conectividade para armazenamento em nuvem e agentes de IA (imagem: reprodução/Plaud)

Após a gravação do áudio, a plataforma usa a tecnogia chamada Plaud Intelligence para fazer a transcrição e gerar resumos.

O produto também conta com um botão físico dedicado à IA no estojo, usado para acionar o Plaud Agent. A partir das informações extraídas, o sistema pode necaminhar o conteúdo para outros serviços, como o Gmail, Google Agenda, Notion e o Slack.

A ideia é entrar em uma categoria em que smartphones também já têm entrado, com transcrição e resumos de gravações em ferramentas nativas. Além dos smartphones, a Apple também parece estar preparando um AirPods inteligente, mas com uma câmera integrada que deve servir para descrever situações ao redor do usuário.
Startup lança fones com IA que gravam e resumem reuniões

Startup lança fones com IA que gravam e resumem reuniões
Fonte: Tecnoblog

Perplexity lança sistema de IA que roda tudo no seu PC

Perplexity lança sistema de IA que roda tudo no seu PC

Processamento local elimina a necessidade de pagar por créditos ou tokens (imagem: Vitor Pádua/Tecnoblog)

Resumo

Perplexity lançou o Portable Computer, um agente de IA que roda direto no hardware do usuário, preservando a privacidade.
O processamento local das tarefas dispensa a cobrança por uso de tokens e impede que dados confidenciais vazem para a nuvem.
O sistema exige alto poder computacional, tendo como requisito mínimo uma placa de vídeo RTX 3090.

A Perplexity revelou o Portable Computer, uma nova versão de sua plataforma de inteligência artificial que é executada no próprio hardware do usuário. O objetivo da iniciativa é tirar as cargas de trabalho da nuvem e levá-las para os computadores locais, garantindo a privacidade absoluta de arquivos sensíveis e cortando os custos gerados pelo consumo de tokens no ambiente corporativo.

A novidade foi desenvolvida em parceria com a Nvidia e já está disponível globalmente para sistemas baseados em Linux. A chegada do suporte oficial para o Windows está agendada para setembro, enquanto arquiteturas Apple Silicon (Macs com chips M) seguem fora do radar de desenvolvimento.

O software liberado na terça-feira (25/08) é uma versão “turbinada” do projeto original “Computer”, introduzido pela empresa em fevereiro deste ano. A versão anterior permitia operar um agente autônomo em dispositivos como o Mac Mini, mas o trabalho pesado de processamento ainda dependia de servidores externos.

Com o Portable Computer, toda a infraestrutura roda de forma isolada na máquina. Para dar conta do recado, o sistema exige equipamentos com alto poder de processamento, limitando o uso inicial a supercomputadores de mesa, como o DGX Spark, e a PCs equipados com GPUs parrudas da linha Nvidia RTX.

Today we’re launching Portable Computer on @NVIDIA DGX Spark.Portable Computer is a fully local version of Perplexity Computer, where the entire runtime: orchestrator LLM, subagent LLM, agent harness all run on your local hardware. No cloud dependency. pic.twitter.com/plVWz5PaAw— Perplexity (@perplexity_ai) August 25, 2026

Como o Portable Computer garante a privacidade?

O mercado corporativo tem mudado seu foco das simples interações de chat para agentes de IA, o que gera uma demanda maior por poder de processamento e faturas altíssimas. Ao executar as tarefas localmente, o usuário simplesmente deixa de ser cobrado a cada requisição. Segundo o vice-presidente de engenharia de infraestrutura da Perplexity, Nate Kupp, a novidade “incorpora tudo o que é necessário para funcionar localmente”.

Caso a capacidade do hardware chegue ao limite durante uma análise muito complexa, o sistema é inteligente o suficiente para adotar um comportamento híbrido. O agente pausa a ação e pede permissão ao usuário antes de acionar um modelo de nuvem mais potente, como o Claude Opus 5.

Para não comprometer a privacidade, o software garante que o modelo remoto devolva apenas orientações em texto, sem jamais ler documentos, pastas e arquivos confidenciais que estão hospedados na máquina.

Execução local garante que dados sensíveis não sejam enviados para fora da máquina (imagem: reprodução/Perplexity)

Quais são os requisitos de hardware?

Devido à alta carga de trabalho autônoma, a Perplexity estabeleceu requisitos rígidos: pelo menos 24 GB de VRAM, o que requer uma GPU de alto desempenho, como a GeForce RTX 3090 ou superior.

No lançamento, o Portable Computer pode ser configurado nativamente com o modelo Qwen 3.8 27B ou o PPLX 27B (uma versão otimizada internamente com base no Qwen).

A documentação oficial da ferramenta também confirmou o suporte iminente à arquitetura Nemotron, composta por modelos de código aberto da própria Nvidia.

Sistema exige placas de vídeo de alto desempenho (imagem: reprodução/Nvidia)

Apesar de rodar localmente, a plataforma conta com forte integração a aplicativos externos como Google Drive, Gmail, GitHub e Slack. Na prática, a IA consegue extrair informações financeiras, mastigar dados de planilhas e compartilhar análises prontas sem qualquer intervenção humana.

Em termos de desempenho, o modelo integrado foi testado no Local Knowledge Work Bench, uma avaliação da própria Perplexity composta por 53 tarefas de análise e pesquisa. Executando o modelo PPLX 27B em um DGX Spark, a precisão bateu os 85,4%. O sistema exigiu menos tempo de processamento em comparação a arquiteturas abertas concorrentes, como o Raspberry Pi e o Hermes, principalmente em testes multimodais e de navegação na web.

Neste primeiro momento, o software está restrito ao Linux e a contas corporativas atreladas aos planos Pro. Segundo a Reuters, a Nvidia estuda um investimento que poderia avaliar a Perplexity em US$ 30 bilhões (cerca de R$ 154 bilhões em conversão direta).
Perplexity lança sistema de IA que roda tudo no seu PC

Perplexity lança sistema de IA que roda tudo no seu PC
Fonte: Tecnoblog

Botão anti-IA do LinkedIn é avaliado positivamente

Botão anti-IA do LinkedIn é avaliado positivamente

Ferramenta contra “lixo de IA” já foi acionada mais de um milhão de vezes (Imagem: Vitor Pádua / Tecnoblog)

Resumo

O LinkedIn reduziu em 40% as visualizações de publicações de baixa qualidade após implementar um botão de denúncia.
A plataforma recebeu mais de 1 milhão de reclamações de publicações geradas por IA.
Um sistema de transparência notifica os usuários quando uma publicação é denunciada como possível texto de inteligência artificial genérico.

O LinkedIn anunciou que conseguiu diminuir em 40% as visualizações de publicações de baixa qualidade geradas por inteligência artificial. A queda drástica ocorre poucas semanas após a rede social liberar um botão de denúncia para esse tipo de material. O objetivo é limpar o feed, penalizar conteúdos que não agregam valor e, a partir de agora, notificar os autores das postagens reportadas pelo público.

O diretor de produtos do LinkedIn, Hari Srinivasan, confirmou que os membros já estão visualizando uma quantidade muito menor de textos robotizados. A nova funcionalidade de moderação, apelidada como “botão contra lixo de IA” (ou “AI slop”, no jargão do setor de tecnologia), teve uma adoção rápida: já foi acionada mais de 1 milhão de vezes desde o lançamento.

Como o algoritmo lida com as denúncias?

Apesar do sucesso, a empresa mantém reservas sobre como processa as denúncias geradas pelos usuários para rebaixar o que considera “conteúdo de baixa qualidade”. Para evitar abusos ou perseguições, foram criados mecanismos que impedem que uma onda de feedbacks negativos seja utilizada para atacar ou silenciar outros membros injustamente.

Isso significa que apenas receber cliques no botão de denúncia não garante que uma postagem será ocultada caso o sistema interno não sustente a suspeita de uso inadequado de IA. A plataforma também realizou ajustes de algoritmo e passou a identificar e reduzir o alcance de publicações que abusam de clichês textuais já reconhecidos como assinaturas de sistemas de IA generativa – como posts que estruturam argumentos em fórmulas previsíveis, como o formato “não é sobre X, é sobre Y”.

A rede da Microsoft também introduziu um sistema de transparência. Os usuários vão receber um alerta sempre que uma publicação sua for denunciada por terceiros como “possível texto de inteligência artificial genérico”. Esse aviso não será exibido publicamente e ficará restrito ao painel de “análise de publicações” do aplicativo.

Exemplo de notificação de um post denunciado (imagem: reprodução/LinkedIn)

Mudança de postura

Um estudo recente conduzido pela empresa de detecção de IA Pangram estimou que mais de 40% das publicações longas no LinkedIn provavelmente foram criadas por inteligência artificial. Esse volume sem precedentes não ocorreu por acaso. O próprio aplicativo adotava uma postura de incentivo ao uso da tecnologia, incluindo até um botão na interface de criação que sugeria “aprimorar” publicações utilizando algoritmos de escrita.

No entanto, essa “facilidade” acabou descaracterizando a plataforma. Reconhecendo o impacto negativo na experiência dos usuários, a empresa optou por remover completamente o recurso assim que lançou a atual ferramenta de denúncia.
Botão anti-IA do LinkedIn é avaliado positivamente

Botão anti-IA do LinkedIn é avaliado positivamente
Fonte: Tecnoblog

Brasil vai gastar R$ 2,3 bilhões para turbinar infraestrutura nacional de IA

Brasil vai gastar R$ 2,3 bilhões para turbinar infraestrutura nacional de IA

Supercomputador reduzirá tempo de treinamento de grandes modelos de IA (imagem: Vitor Pádua/Tecnoblog)

Resumo

O governo brasileiro vai investir R$ 2,3 bilhões para desenvolver uma infraestrutura nacional de IA.
O projeto envolve parcerias com gigantes chinesas e norte-americanas, com o desenvolvimento e compra de supercomputadores.
A estratégia inclui ainda cooperação com a Espanha para produção de semicondutores.

O Governo Federal anunciou um investimento de R$ 2,3 bilhões para o desenvolvimento de uma infraestrutura nacional de inteligência artificial. A iniciativa integra uma nova fase do Plano Brasileiro de Inteligência Artificial (PBIA) e foi apresentada em cerimônia no Rio Grande do Norte, com a presença do presidente Luiz Inácio Lula da Silva (PT).

A estratégia prevê recursos em projetos separados envolvendo empresas dos Estados Unidos e da China. Segundo a nota do governo divulgada nessa quinta-feira (20/08), o objetivo é garantir a soberania nacional sobre os dados brasileiros gerados por serviços públicos e privados, evitando a dependência de uma única empresa, país ou tecnologia.

O PBIA prevê R$ 23 bilhões em aportes. Os recursos para essa nova infraestrutura serão financiados pelo Fundo Nacional de Desenvolvimento Científico e Tecnológico (FNDCT), de maneira parcelada ao longo dos próximos anos.

Aporte bilionário será dividido

A execução da estratégia foi dividida pelo governo em “rotas”. Pouco mais da metade do montante, cerca de R$ 1,3 bilhão, será direcionado a um projeto de supercomputação no Rio de Janeiro, desenvolvido em parceria com as companhias chinesas Huawei e iFlytek ao longo de cinco anos.

A estrutura deve começar a operar em julho de 2027 e terá como foco o desenvolvimento de grandes modelos de linguagem (LLMs), aplicações de inteligência artificial para setores específicos da indústria e a capacitação de cerca de 3 mil profissionais.

Em outro segmento, o Governo Federal destinará R$ 1 bilhão, por edital de licitação, para a aquisição de um supercomputador que deve aparecer entre as dez máquinas de processamento de IA mais poderosas do mundo. A instalação será no Parque Tecnológico Augusto Severo (PAX), no município de Macaíba (RN). A gestão ficará a cargo da Universidade Federal do Rio Grande do Norte (UFRN) e do Laboratório Nacional de Computação Científica (LNCC).

A estimativa é que o processo licitatório dure entre três e seis meses. Segundo a agência Reuters, autoridades avaliam que a norte-americana Nvidia é a empresa com maiores chances de vencer a disputa. Se não houver contestações jurídicas, a previsão é que o supercomputador entre em operação em 12 a 18 meses.

Supercomputador 20 vezes mais potente

Supercomputador brasileiro Santos Dumont possui 27 Petaflops de capacidade (imagem: reprodução/LNCC)

O equipamento adquirido para o Rio Grande do Norte terá capacidade de processamento de 7,2 mil Petaflops. Trata-se de um salto de quase 20 vezes na comparação com o Santos Dumont — atual supercomputador brasileiro localizado no LNCC de Petrópolis (RJ), que entrega cerca de 27 Petaflops.

Na prática, essa diferença resulta em um ganho drástico de tempo. A nova máquina será capaz de treinar um modelo de linguagem de grande escala, similar ao GPT-4, em apenas um mês. Para realizar a mesma tarefa, o supercomputador fluminense levaria de dois a três anos. A infraestrutura ficará disponível para uso governamental, além de empresas, universidades e instituições de pesquisa científica.

O que mais o pacote de IA inclui?

O plano prevê ainda uma terceira rota focada no longo prazo: uma cooperação com a Espanha voltada para a arquitetura de código aberto RISC-V. Com implementação estimada em até 15 anos, o projeto procura transformar o Brasil em um produtor de semicondutores e componentes críticos.

A estratégia governamental engloba ainda planos para um serviço nacional de computação em nuvem e o armazenamento de dados totalmente em território nacional. Para garantir a segurança e a ética dessas tecnologias, foi anunciada também a criação do Centro Nacional de Transparência Algorítmica e IA Confiável.

Operado pelo Centro de Pesquisa Aplicada em IA da Universidade Federal de Minas Gerais (UFMG), o novo órgão terá a missão de auditar sistemas, avaliar riscos, minimizar vieses e criar metodologias de transparência. O núcleo também apoiará a implementação de políticas públicas, como o ECA Digital, mas não substituirá as autoridades competentes na fiscalização e aplicação de sanções legais.
Brasil vai gastar R$ 2,3 bilhões para turbinar infraestrutura nacional de IA

Brasil vai gastar R$ 2,3 bilhões para turbinar infraestrutura nacional de IA
Fonte: Tecnoblog

Um em cada três sites criados após ChatGPT tem sinais de IA

Um em cada três sites criados após ChatGPT tem sinais de IA

Pesquisa analisou a presença de IA em sites publicados pós-ChatGPT (ilustração: Vitor Pádua/Tecnoblog)

Resumo

A pesquisa da Pew Research Center revelou que um em cada três sites criados após o lançamento do ChatGPT em 2022 contém sinais de inteligência artificial, principalmente nos textos publicados
Os textos produzidos com IA apresentam características como uso excessivo de travessões, vírgulas desnecessárias e linguagem rebuscada
De acordo com a Cloudflare, o tráfego de robôs na Internet já superou o de humanos.

O lançamento do ChatGPT em 2022 foi um marco para as inteligências artificiais, que estão cada vez mais presentes em diferentes tipos de conteúdo pela Internet. Uma pesquisa da Pew Research Center traz números para embasar esse argumento: desde a chegada do modelo da OpenAI, um em cada três sites registrados traz IA em algum nível, principalmente nos textos publicados.

O levantamento considerou links recentes e registrou muitos conteúdos com cacoetes de linguagem bastante comuns nas respostas dadas pelos LLMs. Entre eles estão o uso massivo de travessão (–), a chamada vírgula de Oxford, que é desnecessária para a compreensão do texto, assim como a presença de termos rebuscados demais para certas situações.

De acordo com o site TechCrunch, que repercutiu o estudo, esses dados chegam pouco após outra pesquisa, esta do Cloudflare, destacar que o tráfego de robôs na Internet superou o de humanos, algo que aconteceu antes do previsto pela plataforma. Ou seja: mais IAs estão fazendo buscas online e lendo conteúdos escritos também por inteligência artificial.

Recorte maior também chama a atenção

A pesquisa da Pew Research Center levantou informações relevantes quanto ao uso de IA na Internet nos últimos anos. De um total de 10 mil páginas que circulam hoje, pelo menos 10% foram produzidas com uso de IA em algum nível. Vale reforçar que esse é o universo total, considerando também páginas anteriores a 2022, quando o ChatGPT foi liberado ao público. Considerando um recorte mais recente, 35% das publicações trazem inteligência artificial na sua construção.

Mais de um terço dos links publicados após 2022 trazem algum nível de IA em sua composição (imagem: reprodução/Pew Research Center)

Outros dados destacados pela Pew mostram uma presença 10% maior de IA em domínios “.com”, mas textos com cacoetes dos LLMs também podem ser encontrados em slugs com “.edu” e “.gov”, sites normalmente relacionados a plataformas de educação ou do governo dos Estados Unidos. Domínios com “.org” foram analisados também, registrando 4,6% de produções feitas com inteligência artificial.

É importante destacar que a análise foi realizada considerando apenas conteúdos em inglês. Os links foram levantados pela plataforma Common Crawl e a identificação de IA foi feita utilizando o Open Pangram. Segundo o TechCrunch, a ferramenta pode apresentar erros de detecção, mas nada que impeça uma análise a nível “macro”, com um grande volume de páginas.

Características dos textos de IA

As publicações feitas com inteligência artificial têm alguns detalhes que evidenciam o uso da ferramenta. Os textos trazem alguns cacoetes bastante comuns na geração de respostas de IA: um certo exagero no uso de travessões (–), vírgulas desnecessárias e resoluções rasas como “é isso, logo, não é aquilo”.

Conteúdos gerados por IA estão cada vez mais presentes na Internet; saiba como identificar (imagem: Lupa Charleaux/Tecnoblog)

Vale reforçar que alguns desses vícios são comuns em determinadas produções, como nos próprios textos jornalísticos – eu, particularmente, gosto bastante do uso de travessão para organizar certas ideias. Da mesma forma, artigos científicos e publicações acadêmicas também contam com cacoetes do tipo, além de circularem bastante certas ideias para entregar o máximo de detalhes numa explicação, por exemplo.

A diferença está nos cenários em que esses vícios aparecem, normalmente sendo utilizados de maneira desnecessária. A pesquisa da Pew aponta o aumento da frequência desses trejeitos linguísticos como evidência: um uso de vírgulas facultativas 63% maior nos textos, o dobro de palavras comuns em respostas de IA e três vezes mais paralelismo negativo nos textos.

Mais uma evidência de AI Slop nos dias de hoje

Os casos de AI Slop têm sido cada vez mais frequentes na Internet – e não só por aqui. O TB noticiou recentemente os problemas que Consultores Legislativos enfrentam no Congresso dos Estados Unidos ao perder a maior parte do seu tempo revisando projetos de lei com erros clássicos de IA. Da mesma forma, redes sociais como o LinkedIn vêm tentando contornar a situação com uma distribuição menor de posts feitos com IA.

As próprias empresas de inteligência artificial têm conhecimento da presença massiva de conteúdos produzidos por seus modelos na Internet, e utilizam livros impressos lançados antes de 2022 como fonte para treinar suas IAs em um volume cada vez maior. Soma-se a isso a pesquisa da Cloudflare, destacando o tráfego de bots nas pesquisas online superando as buscas humanas.
Um em cada três sites criados após ChatGPT tem sinais de IA

Um em cada três sites criados após ChatGPT tem sinais de IA
Fonte: Tecnoblog

Google paga US$ 10 milhões por dados de companhia aérea falida

Google paga US$ 10 milhões por dados de companhia aérea falida

Spirit Airlines encerrou as operações após duas recuperações judiciais (imagem: reprodução)

Resumo

O Google adquiriu dados corporativos da Spirit Airlines por US$ 10 milhões para treinar modelos de IA.
O pacote inclui milhões de e-mails e linhas de código, além de documentos internos da companhia aérea.
A aquisição visa aprimorar produtos do Google com dados de operações corporativas reais, sem incluir dados pessoais de passageiros ou clientes.

O Google venceu um leilão de falência realizado nos Estados Unidos e adquiriu os dados corporativos da extinta companhia aérea Spirit Airlines. O acordo de US$ 10 milhões (cerca de R$ 52 milhões na cotação atual) transfere o acervo digital da empresa de aviação para a gigante das buscas.

O objetivo é utilizar o vasto histórico de comunicações operacionais e métricas de negócios para treinar modelos de linguagem e aprimorar produtos de inteligência artificial.

O que inclui o acervo leiloado pela Spirit Airlines?

A aquisição engloba um volume gigantesco de documentação, mas a oficialização da compra ainda aguarda a aprovação final de um juiz federal. Segundo os autos do processo, a transferência inclui quase 100 milhões de e-mails corporativos, mais de 500 milhões de chats trocados via Microsoft Teams, agendas, auditorias financeiras e materiais de campanhas de marketing.

O Google também assumirá a posse de 30 milhões de linhas de código, metadados de desenvolvimento, modelos e algoritmos de software da companhia aérea, bem como dados detalhados sobre receita, métricas de operações de aeronaves e relatórios de produtividade de funcionários e de recursos humanos.

Por que o Google quer os dados?

Google investiu em acervo para treinar modelos de linguagem (foto: Felipe Ventura/Tecnoblog)

A big tech pretende processar toda essa documentação para alimentar suas redes neurais com situações e resoluções do mundo corporativo real, já que modelos de IA atuais ainda enfrentam dificuldades em tarefas executivas. Experimentos recentes mostram essa limitação: a Anthropic, por exemplo, colocou seu modelo Claude para gerenciar uma máquina de vendas automatizada, mas o agente tomou uma série de decisões erradas e acabou gerando prejuízo.

A entrada do banco de dados de uma operação logística e corporativa complexa como a da Spirit Airlines oferece elementos valiosos sobre como uma grande empresa lida com fornecedores, gerencia crises e toma decisões de gestão.

Um porta-voz do Google confirmou o plano à agência Bloomberg: “Adquirimos parte de um conjunto de dados corporativos da Spirit Airlines que pode ser útil para aprimorar nossos produtos e modelos de IA”.

Como ficam os dados de passageiros e clientes?

O contrato de venda proíbe a transferência de informações pessoais. Foram excluídos da compra cerca de 97,5 milhões de perfis de passageiros da Spirit Airlines, além de mais de 50 milhões de registros de membros do programa de fidelidade da companhia.

Os dados corporativos vendidos serão categorizados como “desidentificados”, assegurando que nenhum arquivo possa ser atrelado a um indivíduo específico. O contrato também exige que o Google concorde em não desenvolver ferramentas para tentar reidentificar os usuários.

Spirit Airlines encerrou operações em 2026

A ruína da Spirit Airlines ocorreu após a empresa enfrentar duas recuperações judiciais em 2025, amargando perdas de US$ 257 milhões (R$ 1,3 bilhão), e um resgate governamental de US$ 500 milhões (R$ 2,6 bilhões) negado por credores. Em maio deste ano, a companhia encerrou oficialmente suas operações. A Spirit nunca operou voos regulares de passageiros no Brasil.

Segundo o CEO Dave Davis, o serviço tornou-se insustentável devido à alta dos combustíveis impulsionada por conflitos geopolíticos entre EUA, Israel e Irã, selando o primeiro colapso de uma grande companhia aérea americana desde a quebra da Midway Airlines após os ataques de 11 de setembro de 2001.
Google paga US$ 10 milhões por dados de companhia aérea falida

Google paga US$ 10 milhões por dados de companhia aérea falida
Fonte: Tecnoblog